本文主要介绍一些算法基础。内容参考自:算法基础简介 - OI Wiki (oi-wiki.org)
本文主要包括以下内容:算法复杂度,枚举,模拟,递归,动态规划,贪心,前缀和和差分。
算法复杂度
算法的时间复杂度可以看作基本操作的计数或估测,空间复杂度则可以看成算法所需要的空间。假设
考虑
枚举
暴力穷举。但要注意具体枚举方法,以优化代码。
例题
本题最简单的思路自然是枚举所有格子,但是
答案是肯定的。只需要枚举第一列按钮的状态,共计
于是可以写出初版代码:
#include <iostream>
int now[5][6];	//灯泡初始状态
int change[5][6];	//是否按下按钮
int dfs(int depth) {	//返回值代表是否有解
	if (depth == 5) {	//确定了最左边一列五个按钮的状态,开始判断是否可行
		//依次试图填完 change[i][j]
		for (int j = 1; j < 6; j++) {
			for (int i = 0; i < 5; i++) {
				//这个时候要参考位置 change[i][j-1]
				int change_now = change[i][j - 1] + now[i][j - 1];
				if (i >= 1) {
					change_now += change[i - 1][j - 1];
				}
				if (i <= 3) {
					change_now += change[i + 1][j - 1];
				}
				if (j >= 2) {
					change_now += change[i][j - 2];
				}
				change[i][j] = change_now % 2;
			}
		}
		//接下来检查是否合法
		for (int i = 0; i < 5; i++) {
			int change_now = change[i][5] + now[i][5];
			if (i >= 1) {
				change_now += change[i - 1][5];
			}
			if (i <= 3) {
				change_now += change[i + 1][5];
			}
			change_now += change[i][4];
			if (change_now % 2) {	//不合法
				return 0;
			}
		}
		return 1;	//合法
	}
	change[depth][0] = 0;
	if (dfs(depth + 1)) {
		return 1;
	}
	change[depth][0] = 1;
	return dfs(depth + 1);
}
int main() {
	for (int i = 0; i < 5; i++) {
		for (int j = 0; j < 6; j++) {
			std::cin >> now[i][j];
		}
	}
	//思路:只需要枚举 32 种状态
	if (dfs(0)) {
		for (int i = 0; i < 5; i++) {
			for (int j = 0; j < 6; j++) {
				std::cout << change[i][j] << ' ';
			}
			std::cout << std::endl;
		}
	}
}
位运算优化
对于本题而言,从上述代码可以看出,基本思想是逐列确定开关开闭情况。而开关开闭用二进制表示恰好仅占一位,所以可以把一列的开关情况压缩成一个数。随后,只要找到这些数之间的递推关系,就可以得到每一列的开关开闭情况。
递推关系相对是比较容易想到的:假设 6 列初始的灯开灭为 col[6] ,6 列是否需要按下按钮为 change[6] ,那么,对于列 col[i] ,有:
col[i] ^ change[i] ^ change[i - 1] ^ change[i + 1] ^ (change[i] << 1) ^ (change[i] >> 1) == 0;异或了五个数,依次代表对于某一个特定的格子,其本身,左侧,右侧,上方,下方格子按钮对其造成的影响。
需要注意,以上的等式是模 32 意义下的。
为了得到 change 数组的递推关系,稍作化简,便有:
change[i + 1] = col[i] ^ change[i] ^ change[i - 1] ^ (change[i] << 1) ^ (change[i] >> 1);这里利用了 a ^ b == 0 a == b
于是就可以很愉快的编写程序:
#include <cstdio>

inline int read_num() {
	char c;
	while (c = getchar()) {
		if (c == '0' || c == '1') {
			return c - '0';
		}
	}
	return -1;
}

int main() {
	unsigned int col[6] = { 0 };	//6 列初始的灯开灭
	unsigned int change[6] = { 0 };	//6 列是否需要按下按钮
	for (int i = 0; i < 5; i++) {
		for (int j = 0; j < 6; j++) {
			col[j] += read_num() << i;
		}
	}
	//接下来枚举每个可能的 change[0] 初值
	for (unsigned int i = 0; i < 32; i++) {
		change[0] = i;
		for (int j = 1; j < 6; j++) {
			change[j] = (col[j - 1] ^ change[j - 1] ^ (change[j - 1] << 1)
				^ (change[j - 1] >> 1) ^ (j >= 2 ? change[j - 2] : 0)) % 32;
		}
		//检验 change[5] 是否合理
		if ((col[5] ^ change[4] ^ change[5] ^
			(change[5] >> 1) ^ (change[5] << 1)) % 32) {
			continue;
		}
		for (int i = 0; i < 5; i++) {	//合理,输出
			for (int j = 0; j < 6; j++) {
				putchar(((change[j] >> i) & 1) + '0');
				putchar(' ');
			}
			putchar('\n');
		}
		break;
	}
}
模拟
模拟……指让程序完整的按照题目叙述的方式执行运行得到最终答案……这一章对思维与算法设计的要求不高,但是会考验编程的基本功是否扎实。
所谓模拟,重点就是如何将事物抽象,建立起对应的数学模型。
例题
P1065 NOIP2006 提高组 作业调度方案 - 洛谷
本题是一道比较繁琐的模拟题。但只要按照题意模拟每一步即可。
在这种繁琐的模拟题中,尤为需要注意的是每个变量的命名应该清晰直观,以免自己产生混淆。
代码如下:
#include <iostream>
using namespace std;
int main() {
	bool mac[20][8000] = { 0 };	//20 台机器,最大 8000
	int work[20][20];	//i 个工件 j 道工序使用的机器
	int time[20][20];	//i 个工件 j 道工序使用的时间
	int m, n;			//机器数(也即工序数),工件数
	int order[400];		//操作顺序 (m*n 个数)
	int step[20] = { 0 };	//每个工件进行到哪一步
	int time_usage[20] = { 0 };	//每个工件当前最早可用的时间
	int ans = 0;		//最终答案
	cin >> m >> n;
	for (int i = 0; i < n * m; i++) {
		cin >> order[i];
		order[i]--;
	}
	for (int i = 0; i < n; i++) {
		for (int j = 0; j < m; j++) {
			cin >> work[i][j];
			work[i][j]--;
		}
	}
	for (int i = 0; i < n; i++) {
		for (int j = 0; j < m; j++) {
			cin >> time[i][j];
		}
	}
	for (int i = 0; i < m * n; i++) {
		//操作 order[i](工件名)的当前工序 (step[order[i]])
		int mac_now = work[order[i]][step[order[i]]];
		int time_now = time[order[i]][step[order[i]]];
		step[order[i]]++;
		int count = 0;
		for (int j = time_usage[order[i]]; j < 8000; j++) {
			if (!mac[mac_now][j]) {
				count++;
			} else {
				count = 0;
				continue;
			}
			if (count == time_now) {
				ans = j > ans ? j : ans;
				time_usage[order[i]] = j + 1;
				for (int k = j - time_now + 1; k <= j; k++) {
					mac[mac_now][k] = true;
				}
				break;
			}
		}
	}
	cout << ans + 1;
}
递归
一般来说,递归需要有边界条件、递归前进段和递归返回段。当边界条件不满足时,递归前进;当边界条件满足时,递归返回。
也就是说,递归就是通过不断的调用自己,并在这个过程中把问题化简成规模更小的子问题,直到最后子问题可以简单的直接求解,再逐层返回,合并,得到原来问题的解答。
递归的优点
- 结构清晰,方便阅读和编写。
- 求解时只需要关注如何把原问题划分成符合条件的子问题,而不需要过分关注这个子问题是如何被解决的。
递归的缺点
- 对于一些简单的问题,直接(递推)解决即可,递归由于有函数调用的开销,并不是最优选择。
- 递归层数过多可能造成栈溢出。
例题
25. K 个一组翻转链表 - 力扣(LeetCode) (leetcode-cn.com)
链表具有天然的递归属性,因为一个链表,可以看做是一个节点后挂着另一个链表,即递归中更小的子问题。
对于本题,由于是 k 个一组反转链表,所以对于给定的链表除去前 k 个结点,子问题依旧是 k 个一组反转链表。而边界条件就是当剩余结点不足 k 个时,直接返回头结点即可(不需要进行翻转)。
class Solution {
public:
    ListNode* reverseKGroup(ListNode* head, int k) {
        auto node = head;
        for (int i = 0; i < k; i++) {
            if (node == nullptr) {	//不足 k 个一组
                return head;
            }
            node = node->next;
        }
        auto pre = reverseKGroup(node, k);
        while (head != node) {	//翻转当前 k 个结点
            auto temp = head->next;
            head->next = pre;
            pre = head;
            head = temp;
        }
        return pre;
    }
};
可以看到,使用递归的思想编程,代码会显得很简单易懂。
本题的关键是链表翻转后头结点和尾结点间相互的连接。其实递归的思想很容易实现这一点:对于常规的翻转长度为 k 的链表,代码应该是:
auto pre = nullptr;
while (head != node) {
    auto temp = head->next;
    head->next = pre;
    pre = head;
    head = temp;
}
return pre;
原来的头结点被翻转到尾结点,所以 pre 指针初始应该置空。而我们此处还需要将该结点与后面的头结点相连,所以 pre 指针初值置为递归函数的返回值即可。
动态规划
动态规划是一种通过把原问题分解为相对简单的子问题的方式求解复杂问题的方法。
常见的解题思路一般是先写出状态转移方程(用函数表示前后阶段,也即各个子问题之间关系的方程),然后编程解决。
一般来说,对于子问题间关系的处理,有两种常见的方法:递推和递归处理。
前文已经简单介绍了递归的基本思想,但当子问题重叠时,朴素的递归往往不能直接解决问题,这个时候可以采用记忆化搜素或者递推解决。
记忆化搜素
考虑最简单的计算 Fibonacci 数列(1, 1, 2, 3, 5, 8... )的问题。
不难发现状态转移方程
#include <iostream>
int f(int n) {
	if (n <= 1) return 1;
	return f(n - 1) + f(n - 2);
}
int main() {
    std::cin >> n;
	std::cout << f(n);
}
但这个过程中会产生很多的重复计算:
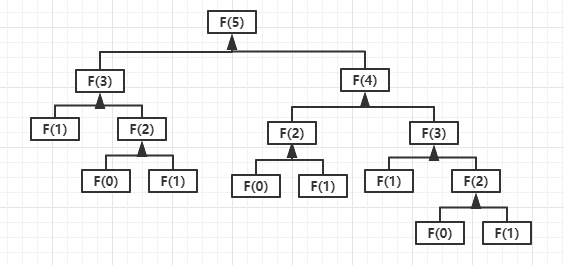
可以看到,为了计算
这个时候可以考虑计算过程中储存已经算过的数据,这也就是记忆化搜素。
例如此处可以采用一个 ans 数组记录:
#include <iostream>
int ans[1000] = { 0 };
int f(int n) {
	if (ans[n]) return ans[n];
	if (n <= 1) {
		ans[n] = 1;
		return 1;
	}
	ans[n] = f(n - 1) + f(n - 2);
	return ans[n];
}
int main() {
	std::cin >> n;
	std::cout << f(n);
}
这样一来,时间复杂度就从
递推
递推是动态规划问题的更常见解法。直接根据状态转移方程,从起始点出发开始递推即可。
例题:接雨水
42. 接雨水 - 力扣(LeetCode) (leetcode-cn.com)
对于本题而言,一个点能接到多高的水,取决于它左右最高柱子的高度,以及这一点柱子的高度。
所以重点是算出某一点左边最高柱子的高度和右边最高柱子的高度。对于点 i 而言,分别采用 l_max[i] 和 r_max[i] 表示。
则某一点能接到的水为:max(min(l_max[i], r_max[i]) - height[i], 0);
而 l_max[i] 和 r_max[i] 有相对清晰的递推关系:
l_max[i] = max(height[i - 1], l_max[i - 1]); 和 r_max[i] = max(height[i + 1], r_max[i + 1]);
故直接递推求解即可。
class Solution {
public:
    int trap(vector<int>& height) {
        int n = height.size(), count = 0;
        vector<int> l_max(n), r_max(n);
        for (int i = 1; i < n; i++) {
            l_max[i] = max(height[i - 1], l_max[i - 1]);
        }
        for (int i = n - 2; i >= 0; i--) {
            r_max[i] = max(height[i + 1], r_max[i + 1]);
        }
        for (int i = 1; i < n - 1; i++) {
            count += max(min(l_max[i], r_max[i]) - height[i], 0);
        }
        return count;
    }
};
例题:摘樱桃
741. 摘樱桃 - 力扣(LeetCode) (leetcode-cn.com)
本题相对复杂,关键是要找到状态转移方程。
对于来时的路和回来时的路,实际上可以看成两条同时从起点出发的路。它们一定总共需要向下 n - 1 步,向右 n - 1 步,也就是总路程确定。
假设某个状态对应两条路上坐标分别是
由于我们令两条路同时出发,所以
后面只要注意边界情况的处理即可。
#define MIN(x,y) (x)<(y)?(x):(y)
#define MAX(x,y) (x)>(y)?(x):(y)
#define MAX_MAP 50
int cherryPickup(int** grid, int gridSize, int* gridColSize){
    int n = gridSize;	//size of the maze
	static int dp[2 * MAX_MAP - 1][MAX_MAP][MAX_MAP];	//(sum,row_1,row_2)

	for (int sum = 2 * n - 2; sum >= 0; sum--) {
		int x_min = MAX(0, sum - n + 1), x_max = MIN(sum, n - 1);
		for (int row_1 = x_min; row_1 <= x_max; row_1++) {
			for (int row_2 = x_min; row_2 <= x_max; row_2++) {
				if (grid[row_1][sum - row_1] < 0 || grid[row_2][sum - row_2] < 0) {	//if blocked
					dp[sum][row_1][row_2] = -1;
					continue;
				}
				if (row_1 > row_2) {	//as symmetry
					dp[sum][row_1][row_2] = dp[sum][row_2][row_1];
					continue;
				}

				dp[sum][row_1][row_2] = -1;	//dp calculation
				if (row_1 != n - 1 && row_2 != n - 1) {
					dp[sum][row_1][row_2] = MAX(dp[sum][row_1][row_2], dp[sum + 1][row_1 + 1][row_2 + 1]);
				}
				if (row_1 != n - 1 && sum - row_2 != n - 1) {
					dp[sum][row_1][row_2] = MAX(dp[sum][row_1][row_2], dp[sum + 1][row_1 + 1][row_2]);
				}
				if (sum - row_1 != n - 1 && sum - row_2 != n - 1) {
					dp[sum][row_1][row_2] = MAX(dp[sum][row_1][row_2], dp[sum + 1][row_1][row_2]);
				}
				if (sum - row_1 != n - 1 && row_2 != n - 1) {
					dp[sum][row_1][row_2] = MAX(dp[sum][row_1][row_2], dp[sum + 1][row_1][row_2 + 1]);
				}
				if (sum == 2 * n - 2) {
					dp[sum][row_1][row_2] = 0;
				}
				if (dp[sum][row_1][row_2] == -1) {	//if no way
					continue;
				}

				if (row_1 == row_2) {	//calculate cherry
					dp[sum][row_1][row_2] += grid[row_1][sum - row_1];
				}
				else {
					dp[sum][row_1][row_2] += grid[row_1][sum - row_1] + grid[row_2][sum - row_2];
				}
			}
		}
	}

    return MAX(dp[0][0][0], 0);
}
贪心
在算法竞赛中求解某些问题时,只需要做出在当前看来是最好的选择就能获得最好的结果,而不需要考虑整体上的最优,即使目光短浅也是没有关系的。
贪心算法指求解问题时每次只考虑使当前步看起来最优。但是由于局部最优解并不一定能到达整体最优解,所以贪心算法需要证明子问题的最优解叠加起来就是整个问题的最优解。
证明方法
假设我们给出了一个(可能的)最优解
- 反证法:如果交换给出的方案中任意两个元素后,答案不会变得更好,那么说明当前方案是最优解。
- 归纳法:先算得出边界情况(例如
)的最优解 ,然后再说明对于每个 , 都可以由 推导出。
例题:国王游戏
话说本题名字好像有些奇怪的意思
这题可以说是非常经典了,解题过程题解区已经说的比较清楚了,假设国王和
上述从直观上理解的过程,其实也就是“贪心”一词的体现。
下面对这个结论证明即可:国王の游戏 - 帅到报警 的博客 - 洛谷博客 (luogu.com.cn)
附上基本思路代码:
#include <cstdlib>
#include <iostream>
struct person {
	int left, right, multi;
};
int cmp(const void* p1, const void* p2) {
	return ((person*)p1)->multi - ((person*)p2)->multi;
}
int main() {
	person people[1001];
	int n;
	std::cin >> n;
	for (int i = 0; i <= n; i++) {
		std::cin >> people[i].left >> people[i].right;
		people[i].multi = people[i].left * people[i].right;
	}
	qsort(&people[1], n, sizeof(person), cmp);	//排序完毕,接下来只需要计算这个答案即可。
    ......
}
后面的计算答案的过程需要用到高精度计算(此处略)
前缀和 & 差分
这两个词听起来高端但其实也就高中数列的思想
前缀和
前缀和是一种重要的预处理,能大大降低查询的时间复杂度。可以简单理解为“数列的前
项的和”。
也就相当于对一个数列
用处非常直观:AT2412 最大の和 - 洛谷
连续排列的
代码:
#include <iostream>
using namespace std;
int main() {
	int n, k, s[100001] = { 0 }, ans = 0;
	cin >> n >> k;
	for (int i = 1; i < n; i++) {
		cin >> s[i];
		s[i] += s[i - 1];
		if (i >= k) {
			ans = max(ans, s[i] - s[i - k]);
		}
	}
	cout << ans << endl;
}
二维前缀和
首先以二维前缀和为例,介绍更一般的多维前缀和的定义。考虑以下矩阵:
可以仿照一维前缀和推广,定义:
得到和矩阵:
根据容斥原理:
可以据此递推关系计算前缀和。
找出一个不包含 0 的最大正方形,则此正方形内全部为 1,而正方形内部所有数字的和可以利用前缀和计算。对于顶点在
故可以据此编写程序:
#include <iostream>
using namespace std;
int main() {
	int s[101][101] = { 0 }, n, m;
	cin >> n >> m;
	for (int i = 1; i <= n; i++) {	//计算前缀和
		for (int j = 1; j <= m; j++) {
			cin >> s[i][j];
			s[i][j] += (s[i][j - 1] + s[i - 1][j] - s[i - 1][j - 1]);
		}
	}
	int length = 2, ans = 1;
	while (length <= min(n, m)) {  //枚举正方形
		for (int i = length; i <= n; i++) {
			for (int j = length; j <= m; j++) {
				if (s[i][j] - s[i - length][j] - s[i][j - length]
					+ s[i - length][j - length] == length * length) {
					ans = max(ans, length);
				}
			}
		}
		length++;
	}
	cout << ans << endl;
}
多维前缀和
多维前缀和的定义可以类似二维前缀和给出。类似地,也可以利用容斥原理给出多维前缀和的计算递推公式,但当维数升高时,其复杂度较高。
这里介绍另一种方法:逐维度拓展。
二维前缀和:
for(int i = 1; i <= n; i++)
    for(int j = 1; j <= n; j++)
        a[i][j] += a[i - 1][j];
for(int i = 1; i <= n; i++)
    for(int j = 1; j <= n; j++)
        a[i][j] += a[i][j - 1];
三维前缀和:
for(int i = 1; i <= n; i++)
    for(int j = 1; j <= n; j++)
        for(int k = 1; k <= n; k++)
            a[i][j][k] += a[i - 1][j][k];
for(int i = 1; i <= n; i++)
    for(int j = 1; j <= n; j++)
        for(int k = 1; k <= n; k++)
            a[i][j][k] += a[i][j - 1][k];
for(int i = 1; i <= n; i++)
    for(int j = 1; j <= n; j++)
        for(int k = 1; k <= n; k++)
            a[i][j][k] += a[i][j][k - 1];
脑内模拟一下就很清楚了(bushi
高维前缀和可以用于解决以下问题:
对于所有的
, ,求
这里说
如果直接枚举计算,相当于每一个
但换个角度来看,在二进制下题目的求和可以看成求
代码:
for(int j = 0; j < n; j++)
    for(int i = 0; i < 1 << n; i++)
        if(i >> j & 1) f[i] += f[i ^ (1 << j)];
类比前面二维,三维前缀和的代码,可以看出外层相当于遍历了
为了满足二进制的形式,这里就需要从 0 开始了,就不能像前面那样取巧置 f[0]=0 ,所以要增加判断条件。总之脑内模拟一下就知道发生什么了
对每个
要求
#include <iostream>
using namespace std;
int first[1 << 18], second[1 << 18] = { 0 };
void merge(int a, int b) {	//a 和 b 提供了 4 个数,相当于让 a 选取最大的两个
	if (first[b] >= first[a]) {
		second[a] = first[a];
		first[a] = first[b];
		second[a] = max(second[a], second[b]);
	} else {
		second[a] = max(second[a], first[b]);
	}
}
int main() {
	int n;
	cin >> n;
	for (int i = 0; i < (1 << n); i++) {
		cin >> first[i];
	}
	for (int j = 0; j < n; j++) {	//前缀和计算
		for (int i = 0; i < 1 << n; i++) {
			if (i >> j & 1) merge(i, i ^ (1 << j));
		}
	}
	int ans = 0;
	for (int i = 1; i < 1 << n; i++) {
		first[i] += second[i];
		ans = max(ans, first[i]);
		cout << ans << endl;
	}
}
差分
和前缀和相对的概念,这个大家在数学上应该很熟悉了。
差分的定义式:
它可以维护多次对序列的一个区间加上一个数,并在最后询问某一位的数或是多次询问某一位的数。
差分通常会和前缀和搭配出现。
例题:地毯
可以利用二维差分解决:这样每次铺地毯就可以
#include <iostream>
using namespace std;
int main() {
	int map[1002][1002] = { 0 }, n, m;
	cin >> n >> m;
	for (int i = 0; i < m; i++) {
		int x1, y1, x2, y2;
		cin >> x1 >> y1 >> x2 >> y2;
		map[x1][y1]++;	//二维差分记录
		map[x2 + 1][y1]--;
		map[x1][y2 + 1]--;
		map[x2 + 1][y2 + 1]++;
	}
	for (int i = 1; i <= n; i++) {	//计算二维前缀和还原
		for (int j = 1; j <= n; j++) {
			map[i][j] += (map[i][j - 1] + map[i - 1][j] - map[i - 1][j - 1]);
			cout << map[i][j] << ' ';
		}
		cout << endl;
	}
}评论加载中...